把模型精度从 FP16 换成 INT8,数值表示更粗了,为什么二者的表现却如此接近,几乎无损?
SmoothQuant 提出了一种方法:量化之前,先调整激活和权重的尺度,让两边都容易量化一些。
这里的激活,是模型计算过程中产生的中间数值;权重,是模型的参数。理解这两边怎么配合,比先记住整套公式更有用。
大数把刻度撑开了
可以把量化想成用一把有限刻度的尺子记录数值。范围越大,相邻刻度之间的距离通常也越大,小数值的细节就容易挤在同一格里。
例如,采用一种常见的对称 INT8 约定,用整数码 -127 到 127 表示范围 -100 到 100。步距大约是:
|
|
原始值 70 对应整数码 89,恢复尺度后是约 70.079。原始值 1 和 0.8 都会对应整数码 1,恢复后都约为 0.7874,原本的区别就丢了。
所以,整数码是一个刻度编号。原始值小于 128,也不意味着它能被 INT8 原样存下。
这是教学例子,步距由设定的范围决定,不是 INT8 固定为 0.7874。
SmoothQuant 原论文观察到,一些模型的激活中,少数通道的幅值持续很大。如果各通道共用一把尺子,这些大数会把范围撑开,其他小数就不好记录了。
激活除,权重乘
线性层需要把激活和权重相乘。激活缩小一点,对应权重放大一点,可以保持原来的乘积。
拿一个简单的数值例子看:
|
|
SmoothQuant 把这个办法用到每个输入通道上:激活除以一个比例,对应权重乘以同一个比例。各项乘积保持不变,最后加起来的结果也保持不变。
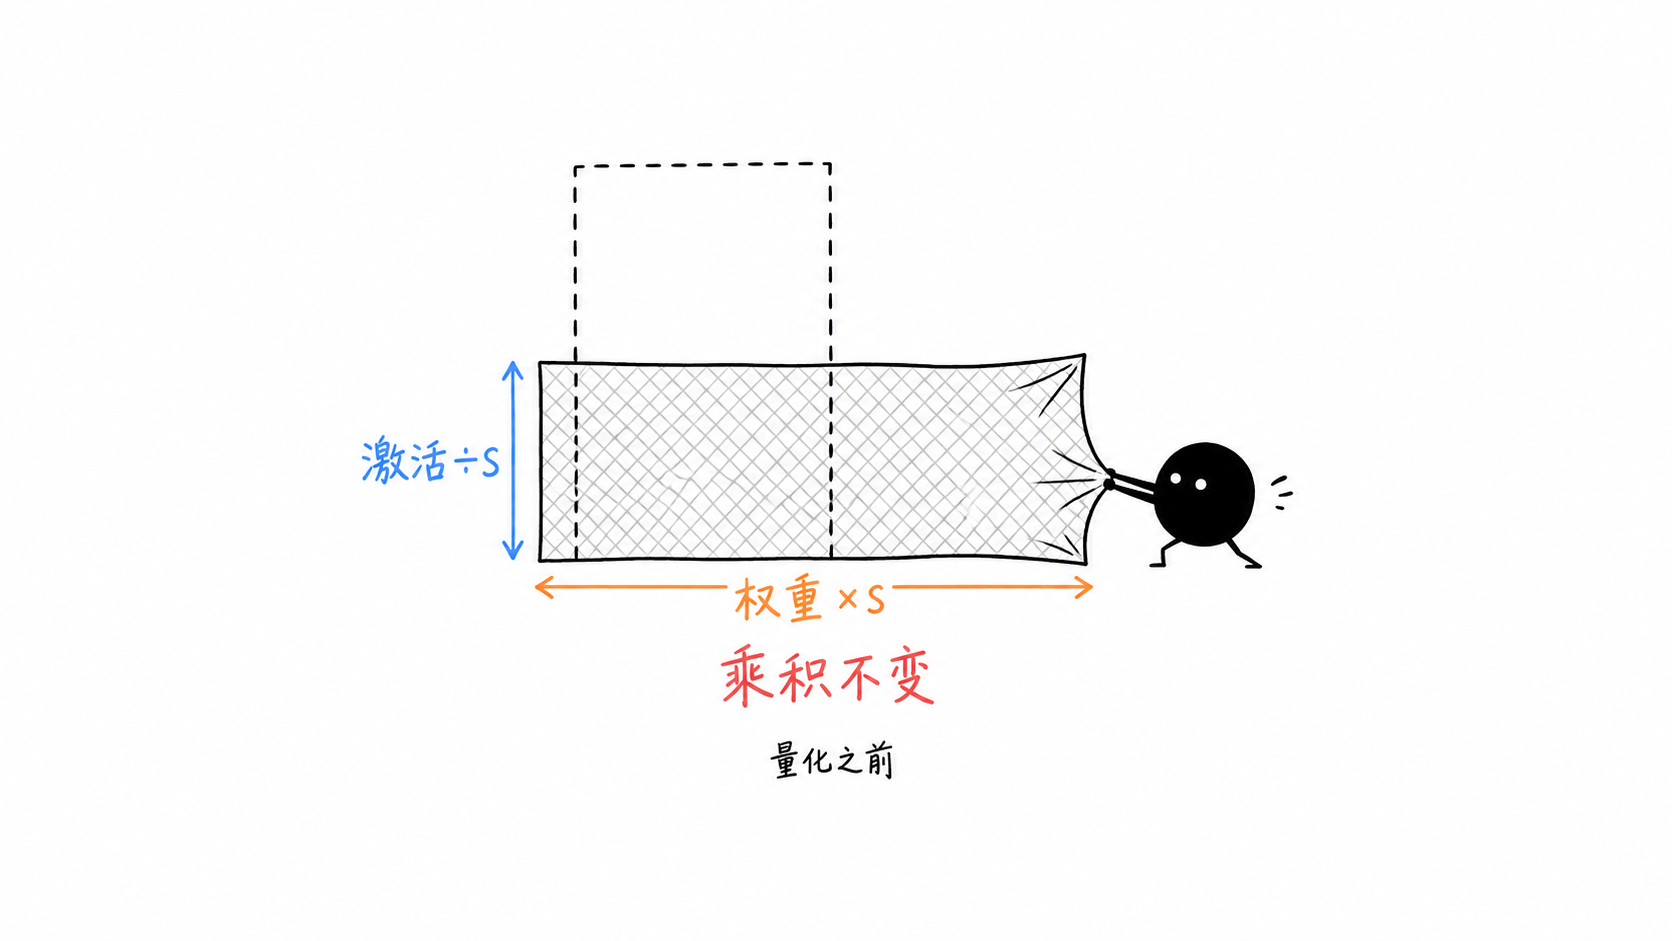
图里的面积只是帮助理解互逆缩放,表示的是量化之前的计算。
实际处理时,不同通道会选不同的比例。激活中的大通道可以降下来,权重吸收相应的比例。把所有激活统一缩小同样的倍数,并不能自动改善量化误差。
比例也不能随便选。压激活压得太狠,权重可能变得难以量化。方法会用校准数据估计通道幅值,再平衡两边的负担。
这里调整的是通道尺度。后面量化时,仍可以让整个张量共用一个步距,也可以给每个 token 位置的激活向量单独定步距。“按通道平滑”和“按通道量化”是两种不同的方法。
示例:把三个通道都算一遍
取四个 token,每个 token 有 A、B、C 三个通道。下面按 T1 到 T4 的顺序列出激活,以及对应的权重:
|
|
这是教学数据,不是论文实测。未量化的结果作为基准;比较的两条路线,都对整张激活、整张权重分别使用一个对称 INT8 步距,舍入到最近刻度,不额外主动裁剪。
先直接量化。 激活最大绝对值为 100,因此步距是 100 ÷ 127,约 0.787402。
例如 B 通道的 1:除以步距约为 1.27,舍入成整数码 1,反量化后约为 0.787402。绝对误差就是两者之差的绝对值,约 0.212598。
再按论文方法平滑。 取平衡参数 alpha = 0.5,各通道的缩放比例这样计算:
|
|
激活分别除以上面的比例,权重乘回来。激活三个通道的最大幅值变成约 1、1、0.948683,权重变成约 1、1、0.948683。这次激活和权重的最大绝对值都是 1,两者各自的量化步距都为 1 ÷ 127,约 0.007874。
仍以 B 通道的 1 为例:
|
|
下面把所有值放在一起。为了公平比较,Smooth 路线的激活反量化后,都先乘回各通道的缩放比例,再与原值求差。这一步只用于比较同一尺度上的误差,实际线性层使用平滑后的激活与权重相乘。 表中保留六位小数,计算用未舍入值。
通道 A
| 原值 | 直接量化后 | 绝对误差 | Smooth 后换回原尺度 | 绝对误差 |
|---|---|---|---|---|
| 100 | 100.000000 | 0.000000 | 100.000000 | 0.000000 |
| 80 | 80.314961 | 0.314961 | 80.314961 | 0.314961 |
| -70 | -70.078740 | 0.078740 | -70.078740 | 0.078740 |
| -100 | -100.000000 | 0.000000 | -100.000000 | 0.000000 |
四个值的平均绝对误差:0.098425 → 0.098425。
通道 B
| 原值 | 直接量化后 | 绝对误差 | Smooth 后换回原尺度 | 绝对误差 |
|---|---|---|---|---|
| 1 | 0.787402 | 0.212598 | 1.007874 | 0.007874 |
| -1.5 | -1.574803 | 0.074803 | -1.496063 | 0.003937 |
| 2 | 2.362205 | 0.362205 | 2.000000 | 0.000000 |
| -2 | -2.362205 | 0.362205 | -2.000000 | 0.000000 |
四个值的平均绝对误差:0.252953 → 0.002953。
通道 C
| 原值 | 直接量化后 | 绝对误差 | Smooth 后换回原尺度 | 绝对误差 |
|---|---|---|---|---|
| 0.8 | 0.787402 | 0.012598 | 0.796794 | 0.003206 |
| -0.7 | -0.787402 | 0.087402 | -0.697195 | 0.002805 |
| 1.5 | 1.574803 | 0.074803 | 1.493989 | 0.006011 |
| -1.2 | -1.574803 | 0.374803 | -1.195192 | 0.004808 |
四个值的平均绝对误差:0.137402 → 0.004207。
A 的误差基本不变,B、C 的误差则明显降低。它们不再挤在由 A 撑开的粗刻度上。
最后还要看权重和输出。 直接路线的权重步距为 0.6 ÷ 127,平滑路线为 1 ÷ 127。得到的权重是:
| 通道 | 原始权重 | 直接量化后 | 平滑后、尚未量化 | 平滑再量化后 |
|---|---|---|---|---|
| A | 0.01 | 0.009449 | 1.000000 | 1.000000 |
| B | 0.5 | 0.500787 | 1.000000 | 1.000000 |
| C | 0.6 | 0.600000 | 0.948683 | 0.944882 |
这里的权重反量化值保留在各自路线的尺度上。直接路线使用原始激活的反量化值;Smooth 路线使用平滑激活的反量化值,两侧都已量化。
T1 未量化的输出是:100 × 0.01 + 1 × 0.5 + 0.8 × 0.6 = 1.98。其余位置也按三个通道的乘积求和:
| 位置 | 未量化输出 | 直接 W8A8 输出 | Smooth W8A8 输出 |
|---|---|---|---|
| T1 | 1.980000 | 1.811644 | 1.980098 |
| T2 | -0.370000 | -0.502201 | -0.361523 |
| T3 | 1.200000 | 1.465683 | 1.192014 |
| T4 | -2.720000 | -3.072726 | -2.714241 |
四个输出的平均绝对误差,从 0.229742 降到 0.005580。
这组例子展示了 SmoothQuant 的核心工作:按通道迁移尺度,保持量化前的计算,再让激活和权重以较小的联合误差进入 INT8。它改善了这组数据的输出,但没有把舍入误差清零。
乘积搞定了,舍入误差仍然存在
前面的乘法例子使用精确数值。真正换成 INT8 时,激活和权重都要落到整数刻度上,舍入误差仍然会出现。实际浮点运算也不保证变换前后逐位相同。
SmoothQuant 改善的是量化条件,让最终的误差尽量小,并不保证每一个数都比之前更准确。
至于“小了多少”,需要看实验。
原论文 Table 3 中,OPT-175B 的 FP16 基线在 WikiText 上的 PPL 是 10.99,SmoothQuant-O3 是 11.17,约上升 1.64%。七个零样本任务的平均准确率,从 66.9% 变成 66.8%。
说明在这组模型、数据和配置下,量化后的表现接近 FP16,而不是所有数值完全相同。平均结果也会掩盖具体任务的差别。
模型变了,校准数据变了,效果还需要重新检查。W8A8 也不意味着整个网络都使用 INT8,原论文里的 Softmax、LayerNorm 等运算仍保留浮点精度。
因此,我理解的“近乎无损”有个具体落点:用更低精度完成主要计算,同时在评测中维持大部分能力。输出的文本能不能让人也觉得没区别,还需要另外验证,至少我现在不这么认为。
参考:SmoothQuant 原论文,主要对应 Equation 3、4 和 Table 3;官方代码。困惑度的计算见上一篇:困惑度,从一句话算起。