直插现场
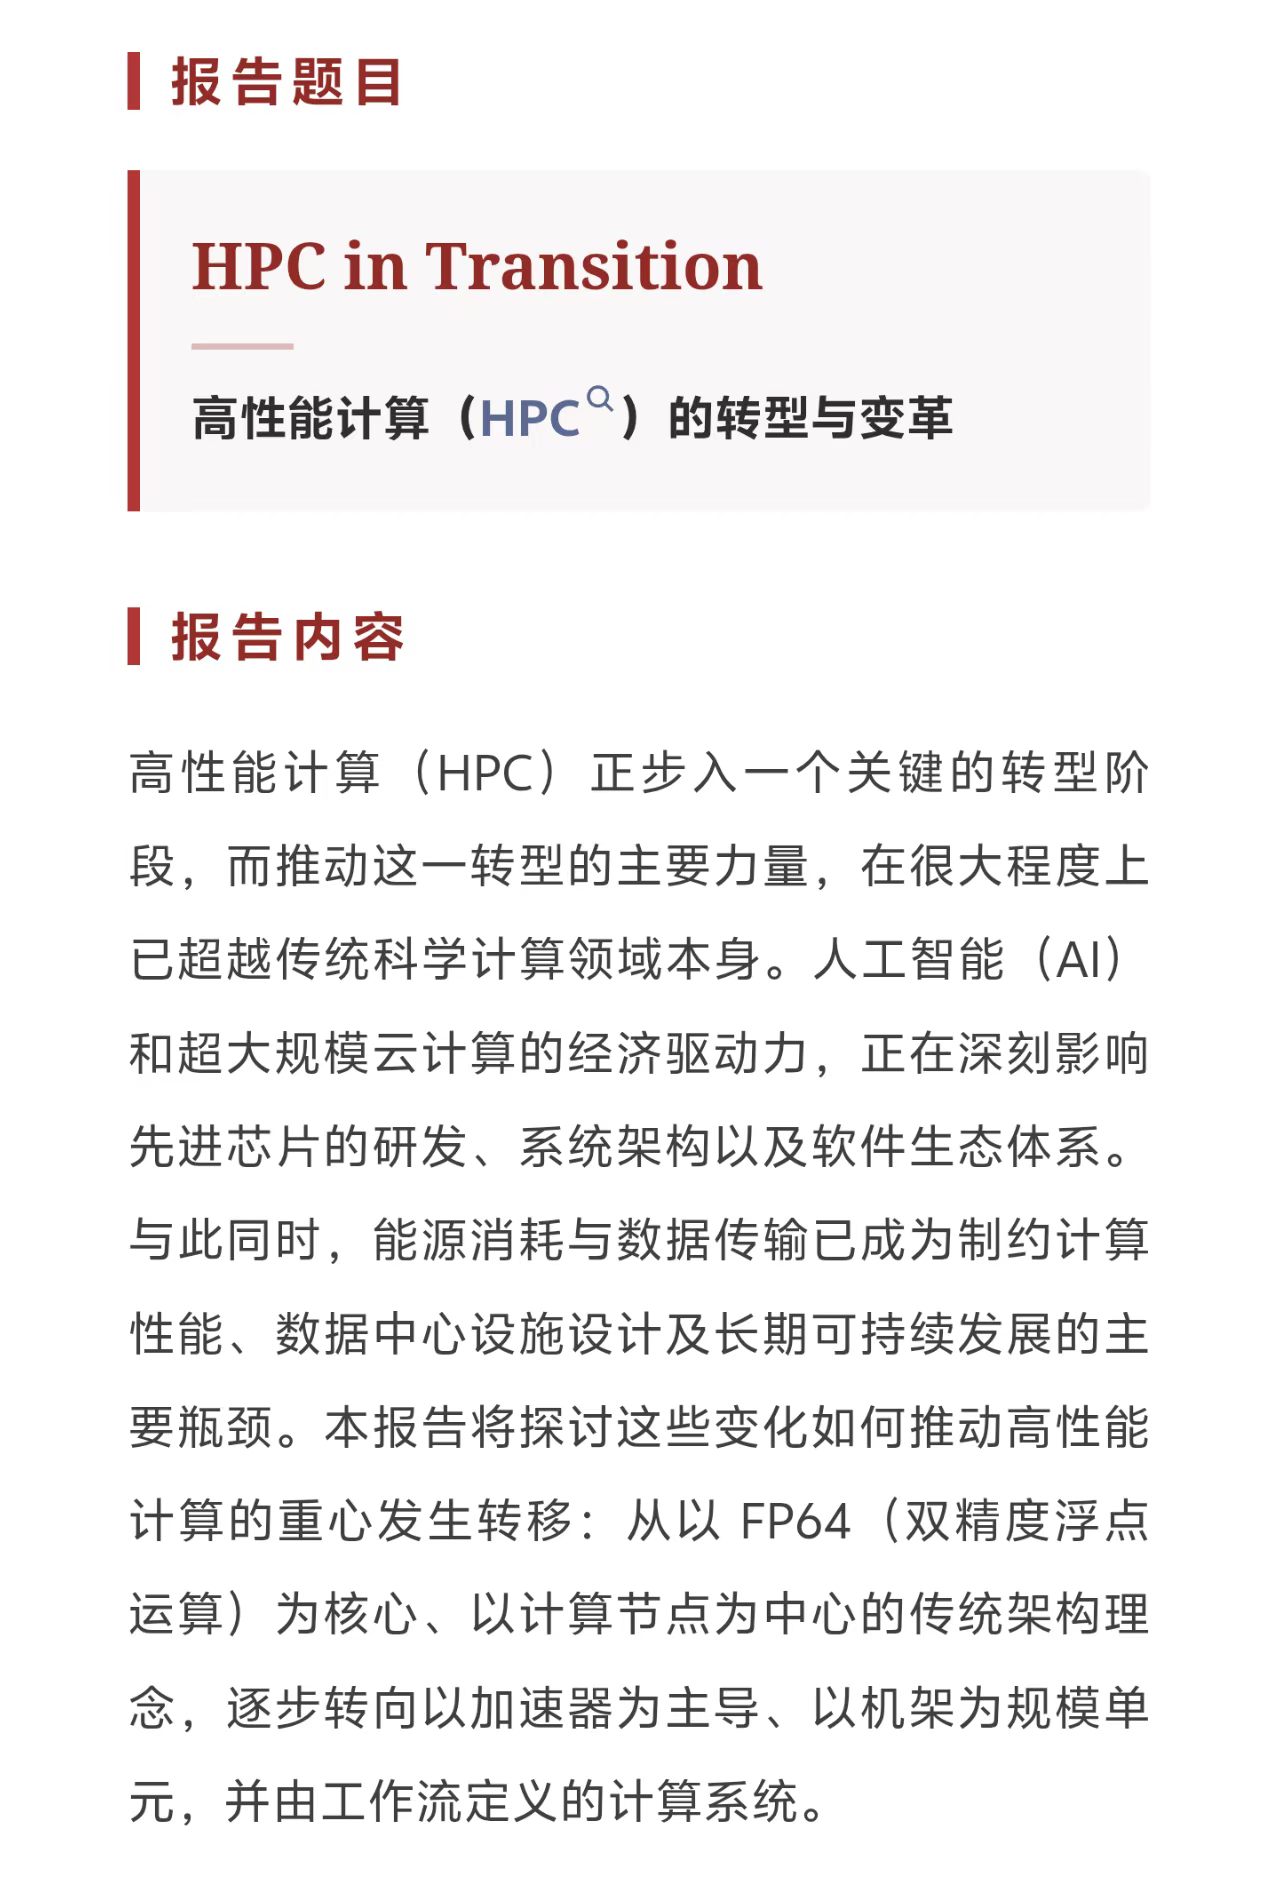
10 月 30 日,学院官号发了一条推文:2021 年 ACM 图灵奖得主 Jack Dongarra 教授要来学校做学术报告,题目是 HPC in Transition,也就是“高性能计算的转型与变革”。与我的研究方向很相关,我随即转发到了组内群里,却又补了一句:“可能是面向老师的。”
确实,在我的印象里,有些报告面向特定人群,推文里又没有写“欢迎全体师生前来学习交流”。以前也有过好几次,等我在学院微信公众号上看到消息,才知道几天前办过一场报告。
导师回了一句:“肯定是面向全校师生的啊。”随后又说:“鼓励大家都去听听,跟咱们工作非常相关。”
这下有底气了,我也有了如下判断:
本次学术报告面向全体师生,但不是在大会议室进行,提供的座位有限,先到先得。
事实证明,我是对的。
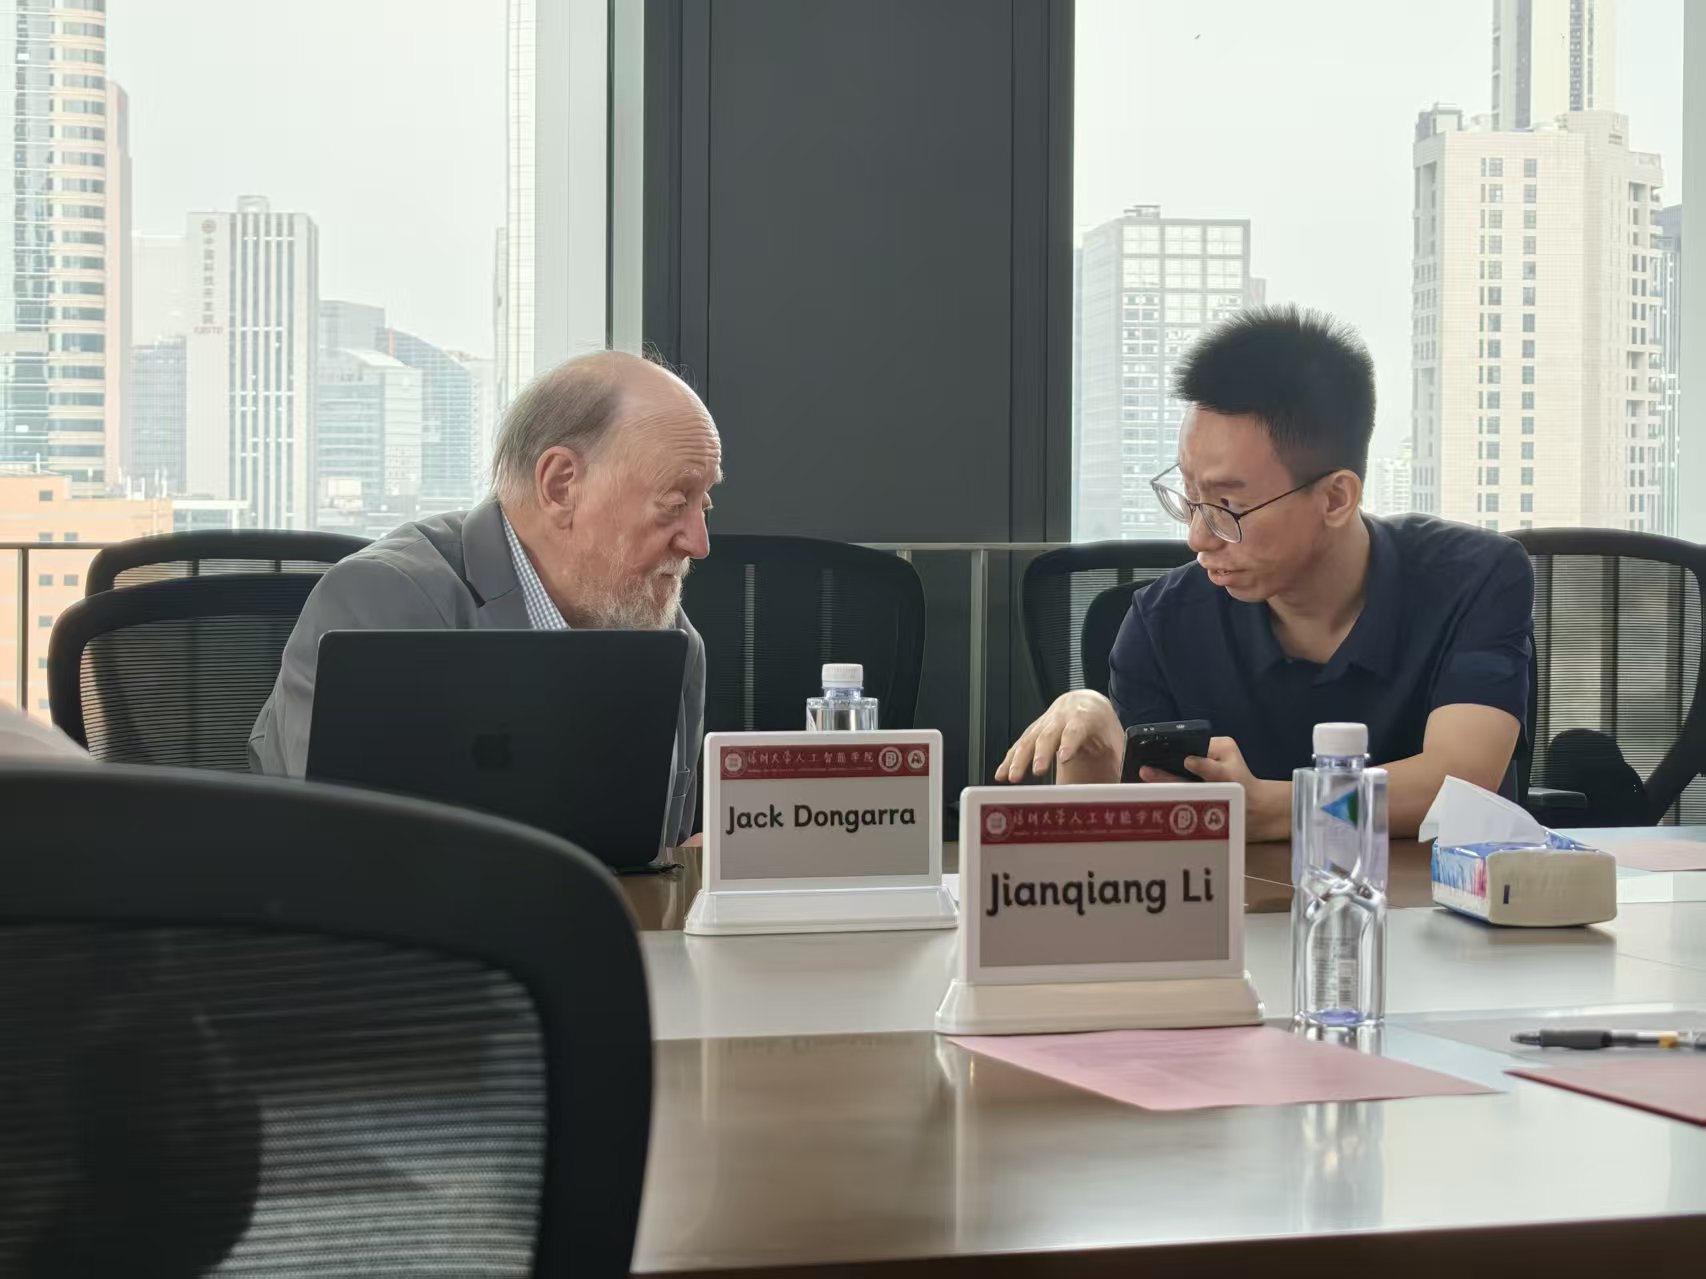
报告下午 15:30 开始,但在 14:15—17:25 有连着的新时代课程,而且还是最后一次课:要点名、交纸质作业,还要做小组 PPT 汇报。于是周五晚跟组员商量好替我做PPT的汇报,今天第一节课去签到交作业,14:55下课也是一个闪现到学术报告现场。好巧不巧,刚出电梯就看见一群人在门口,陪同人员正开门带教授准备参观一下,我也就混在其中(讲解员os:好像混进来一个奇怪的东西)。随着时间来到15:30,老师们一个个落座,像我一样是学生身份的应该有接近12个人。
AI 改变高性能计算
这次报告讨论的是:AI 正在怎样改变高性能计算,以及科研和教育应该怎样适应这些变化。下面是我最有感触的几个部分,也穿插了一些自己的理解。
Dongarra 长期研究数值线性代数与高性能计算软件,参与了 LINPACK、LAPACK 等软件的开发。1 报告中,他把高性能计算比作一种“科学仪器”:通过数学建模和计算模拟,帮助人们研究气候、能源、材料、药物等问题。
说到超级计算机的性能,经常会碰到 LINPACK。它涉及的是数值线性代数;TOP500 排名使用的 HPL 基准,通过求解稠密线性方程组来衡量系统的双精度浮点计算性能。这里的双精度是 64 位,也就是 FP64。2
一个离我们很近的例子,是部署在国家超级计算深圳中心的 LineShine(灵晟)。2026 年 6 月 TOP500 公布的 HPL 实测成绩约为 2.198 EFLOP/s,即每秒 2.198×10¹⁸ 次浮点运算。这是特定基准下测得的性能,不能直接当成理论峰值,更不能理解为所有应用都能达到这个速度。3
这个数量级有多大?如果按 80 亿人、每人每秒做一次运算来粗略换算,要连续算约 8.7 年,才相当于它在这个基准下约一秒的运算量。当然,这只是帮助理解数量级。
但机器算得快,应用就一定跑得快吗?
在许多使用 GPU 加速的系统里,GPU 承担大量并行数值计算,CPU 也承担调度、控制和部分计算任务。计算单元还得不断获得数据:数据要从内存进入芯片,也可能在 CPU 与 GPU、不同 GPU、不同节点之间传递。数据没到,依赖它的计算就只能等。
所以,除了计算能力,还得看数据能不能及时送到、通信与计算能不能重叠,以及供电和散热能否支撑系统运行。具体哪个环节最慢,要看任务和系统;不能一概说所有应用都只受通信限制。
这也太巧了
这又是一件很巧的事。上周导师的课上,我汇报的题目正是“大模型训练网络:GPU 集群的通信瓶颈”。当时就在讲,GPU 之间怎样交换数据,会直接影响整个训练任务的效率。
比如,数据并行需要同步梯度,张量并行需要在层内交换中间结果,流水线并行需要在相邻阶段之间传递数据。即便每张卡都很快,通信结果没有及时到齐,下一步计算仍然可能被卡住。
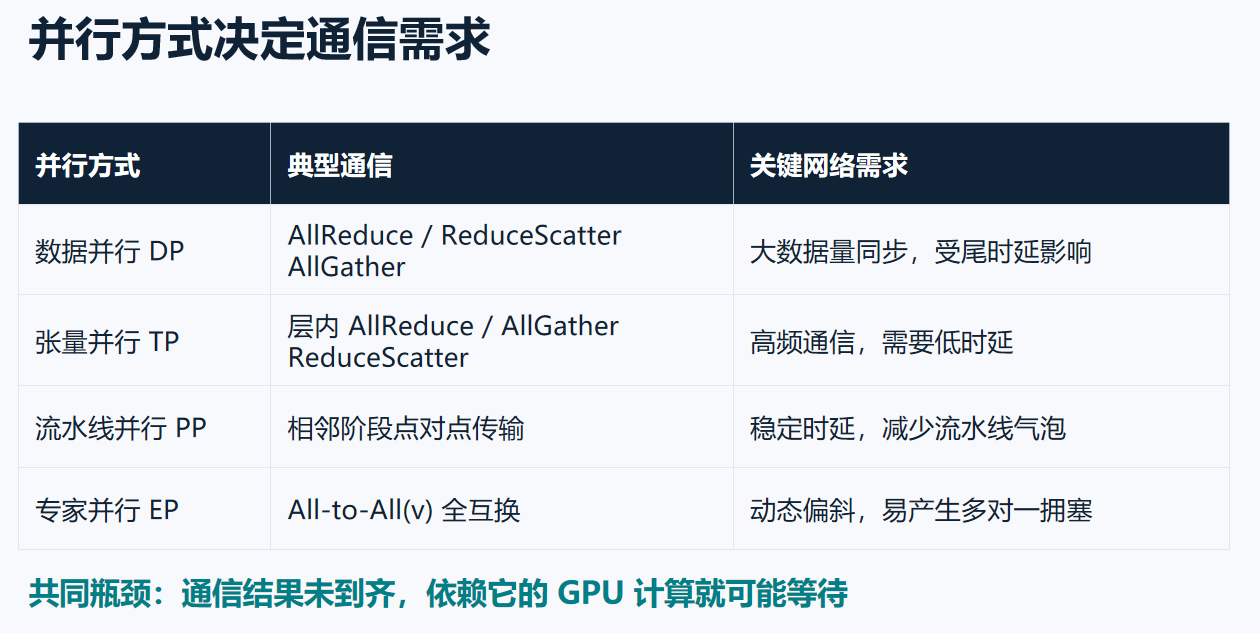
拿一个夸张的例子来说:假如给我一亿张 A100,能不能一秒钟训练好一个超大模型?显然不能只按卡数去推算。模型能怎样拆分、每一步需要交换多少数据、网络带宽和时延如何,都会限制扩展效率;训练本身也有前后依赖的步骤。
低精度计算
另一个与我近期工作很相关的部分,是低精度计算。
许多深度学习模型的主要计算可以归结为密集矩阵运算。它们不一定要求所有步骤都使用 FP64,而是可以根据训练或推理的需要,采用 FP32、FP16、BF16、FP8 等格式,或结合整数与混合精度计算。
这里需要分清的是:低精度减少的是每个数值的表示位数,不意味着算法要做的乘加次数一定变少。 它可能减少存储和数据传输的负担,也可能让硬件在相同时间内完成更多运算。但计算中的累加、某些敏感步骤,仍可能需要较高精度。
AI 的需求也在影响芯片设计。AI 是由小型矩阵计算驱动的。也就是密集矩阵计算。我们可以看到看到低精度计算正在快速增长。所以 AI 不需要 64 位的算术运算。它们也不需要 32 位。它们实际上需要的运算量要少得多。所以像 NVIDIA 这样的公司,正在制造能进行低精度计算的处理器。并且有个很反常的现象:英伟达的新芯片在 64 位算术运算上比旧芯片运行得更慢。
对于科学计算,接下来的问题就更有意思了:能不能让大部分计算使用低精度,再通过必要的高精度计算、误差检查或迭代修正,获得满足要求的结果?
这也是我正在关注的低精度研究。不过,数值计算中的误差控制,与语言模型量化后的任务表现,各自的评价方法不一样。
硬件、算法和软件协同
报告中还有一个让我印象很深的方向:把矩阵加速能力集成到 CPU 中,再配合高带宽内存,探索不同于独立 GPU 加速器的系统设计。
一个很好的例子是国产的龙芯架构,无需GPU,直接将矩阵乘法集成在了芯片内部,以及对应的HBM。以往的架构里,GPU是独立的部件,那就需要写两套程序,开发者需要同时考虑 CPU 与 GPU 上的计算分工,以及不同存储空间之间的数据传输,如果硬件组织方式改变,数据移动和编程的成本也可能随之改变。
近期相关
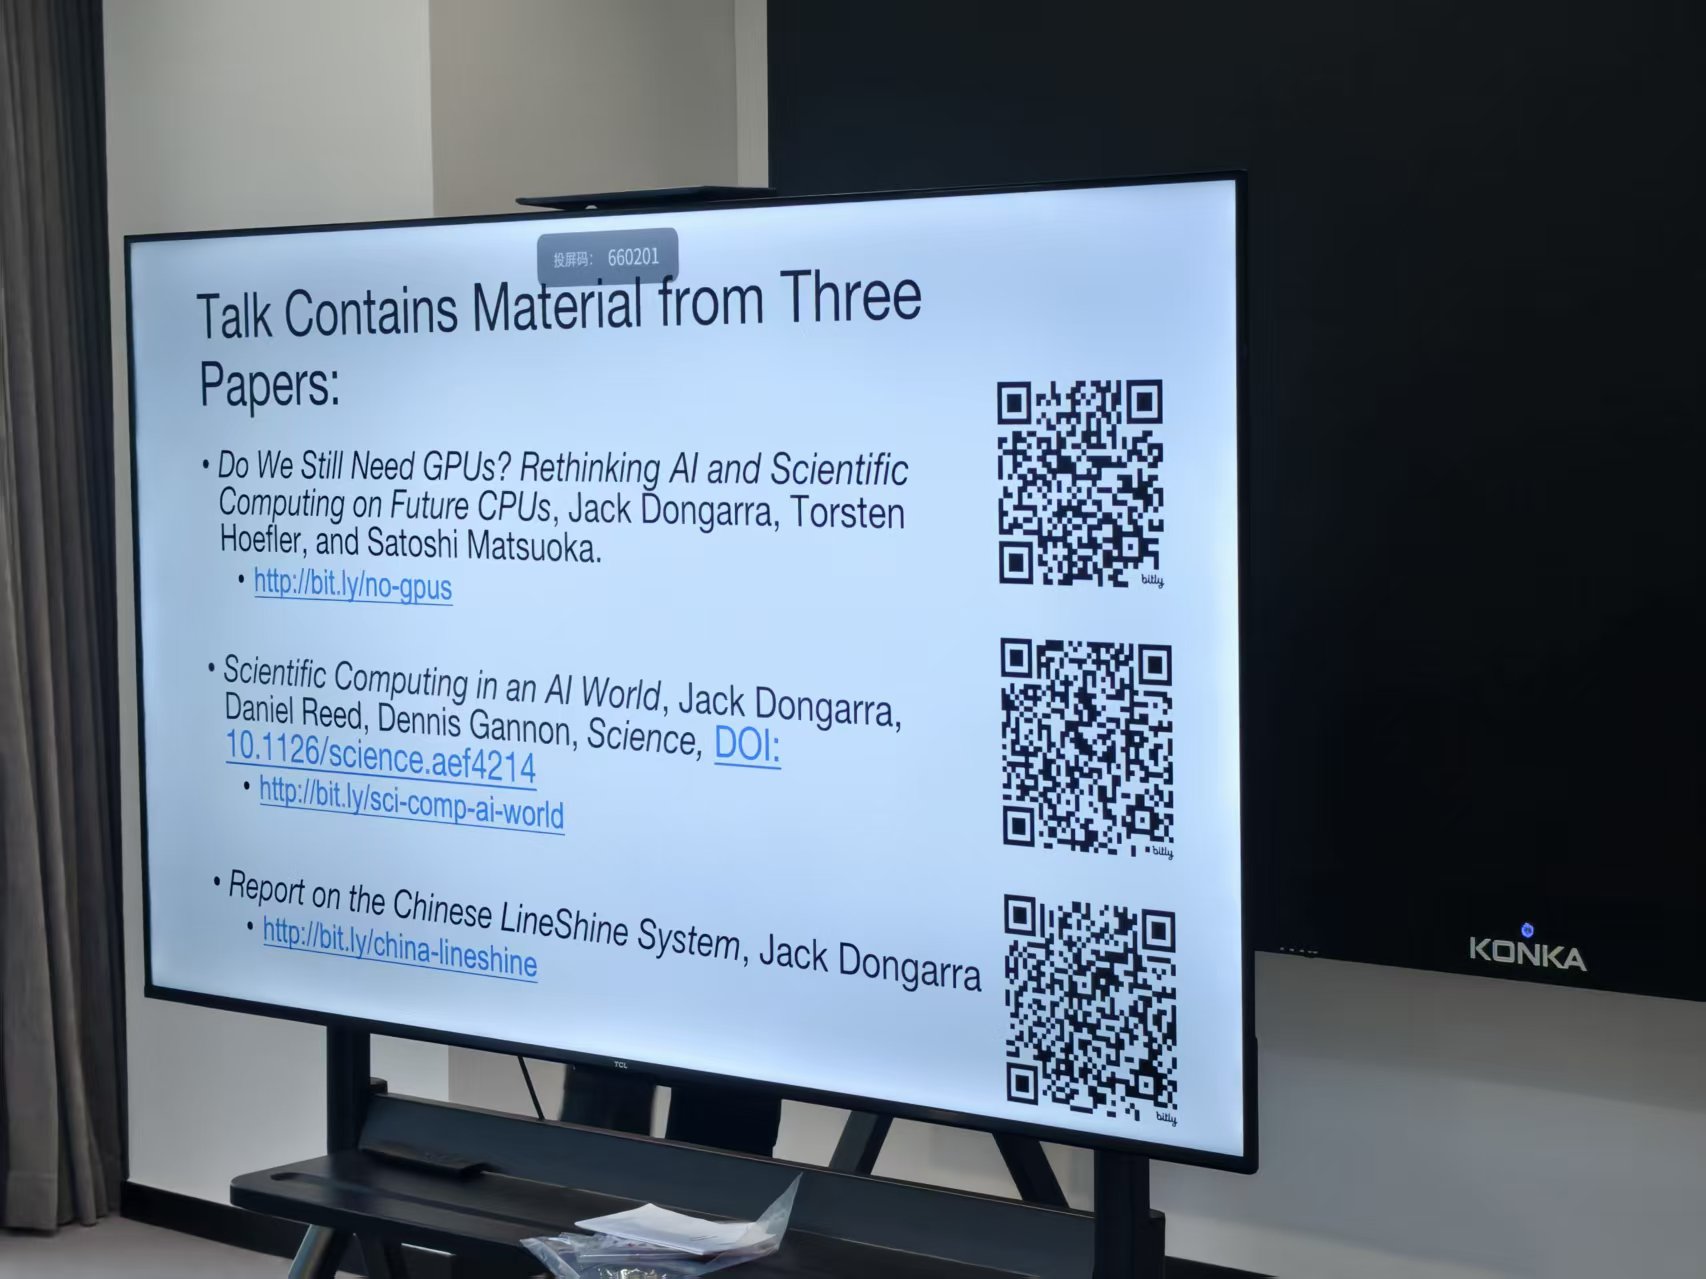
报告中列出了三份相关材料,感兴趣的盆友可以点击阅读:
- Do We Still Need GPUs? Rethinking AI and Scientific Computing on Future CPUs,Jack Dongarra、Torsten Hoefler、Satoshi Matsuoka。
- Scientific Computing in an AI World,Jack Dongarra、Daniel Reed、Dennis Gannon。现场幻灯片标注了这个题名与 DOI;作者主页另提供了一份相关稿件 Ride the Wave, Build the Future: Scientific Computing in an AI World。
- Report on the Chinese LineShine System,Jack Dongarra。
当然,最后也有机会和大佬合照、拿到签名,哈哈哈哈,有种追星成功的感觉。
合照里的我换成了小侦。
-
Jack Dongarra 作者主页,列有其研究方向、软件工作与获奖信息。 ↩︎
-
TOP500 2026 年 6 月榜单,区分 HPL 实测性能 Rmax 与理论峰值 Rpeak。 ↩︎