语言模型的评测表里,经常会出现困惑度,英文叫 Perplexity,简称 PPL。通常越低越好。
不过,只记住“越低越好”,两个模型的困惑度差了零点几,究竟意味着什么?
这篇文章以这句“我爱吃苹果。”介绍一下困惑度。
给原文打分
为了方便,假设这句话被分成五个 token:我、爱、吃、苹果、句号。token 是模型分词后的基本单位,实际分词不一定这样,这里就按这个例子来。
评估时,我们依次检查:看到“我”,模型给“爱”多少概率;看到“我爱”,给“吃”多少概率;后面也是一样。
| 模型看到的前文 | 原文接下来的 token | 模型分配的概率 |
|---|---|---|
| 我 | 爱 | 0.428671… |
| 我 爱 | 吃 | 0.55 |
| 我 爱 吃 | 苹果 | 0.62 |
| 我 爱 吃 苹果 | 。 | 0.80 |
这些概率是教学设定,不是实测结果。第一项保留省略号,是因为实际计算用了未舍入的数值。
模型先给整个词表里的候选打分,再通过 softmax 转成概率。计算 PPL 时,每个位置只取原文中那个真实答案的概率。
即使模型看到“我”之后最想接“吃”,下一步也依然输入原文的“我爱”。它不负责自由续写,我们只检查它给这段原文打了多少分。
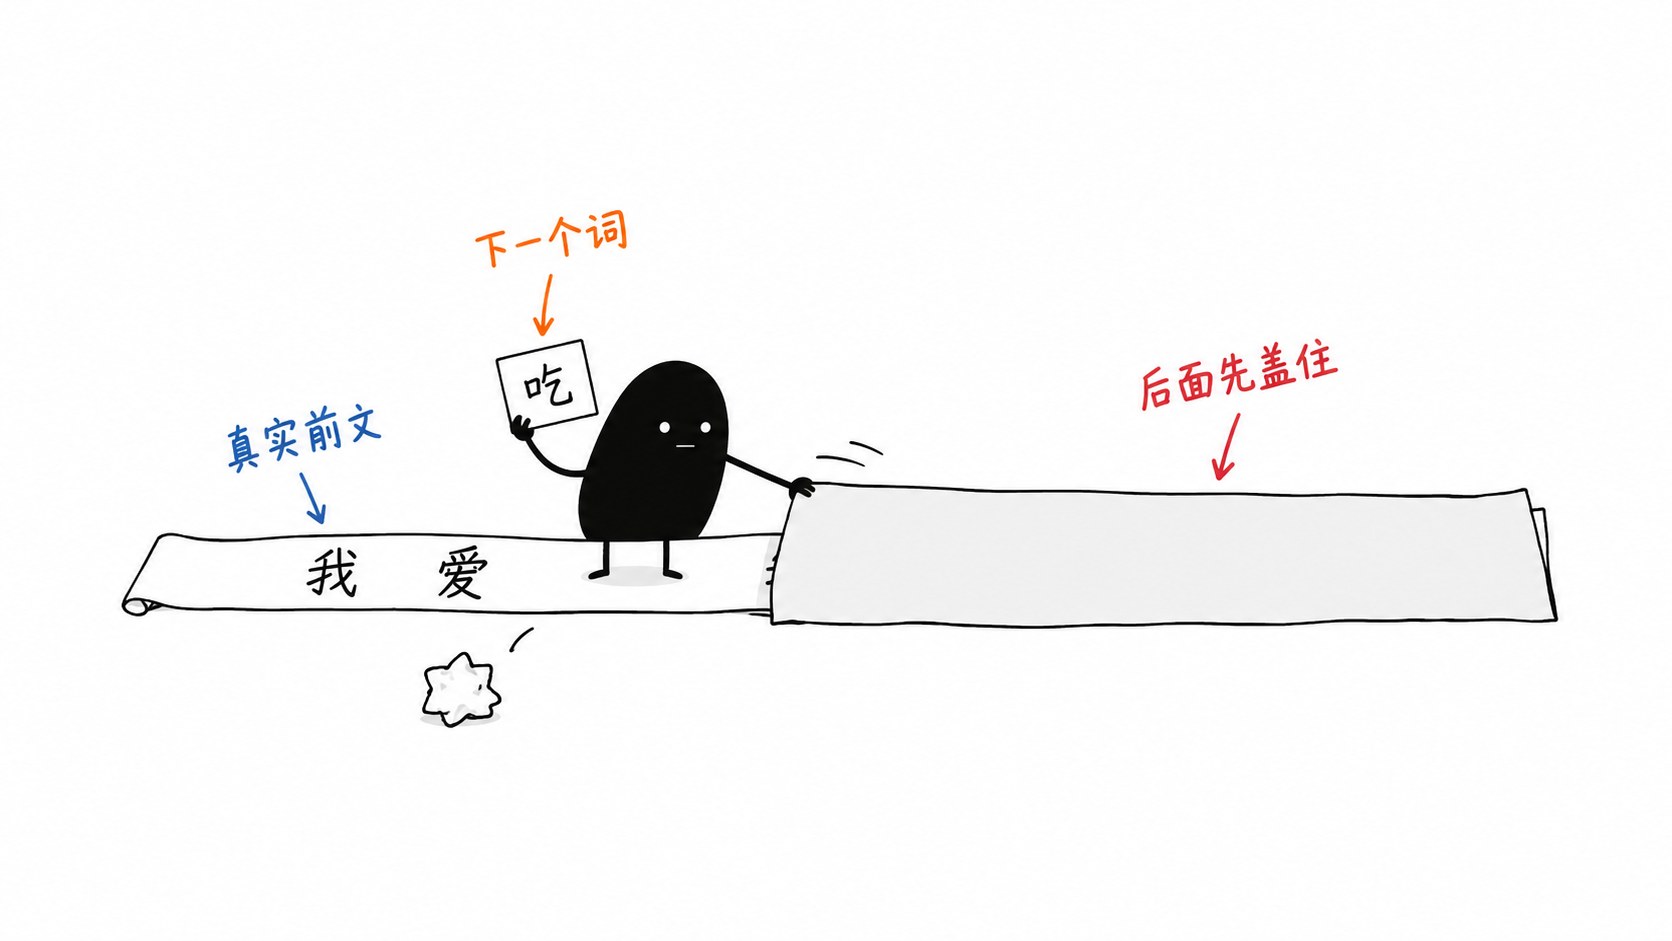
整句话可以一次送进模型。因果注意力掩码会限制各位置可见的内容,预测“吃”时能用“我爱”,但不能偷看后面的“苹果”。
还有一点:表里的 0.55 是看到“我爱”之后给“吃”的概率。只看到“我”时,“吃”也可能有另一个概率,两者不能混用。
把四个概率算成一个数
先对每个目标概率取负的自然对数,得到 NLL,也就是负对数似然。用计算器的 ln 功能就可以算。
| 目标概率 | NLL,约等于 |
|---|---|
| 0.428671… | 0.8471 |
| 0.55 | 0.5978 |
| 0.62 | 0.4780 |
| 0.80 | 0.2231 |
概率越高,损失越小。模型给正确答案很低的概率,会受到更大的惩罚。
把四项损失平均,再取指数:
|
|
exp 表示以自然常数 e 为底的指数。这两步用的是未舍入的中间值,表中的四位小数只方便阅读。
本例只有四个目标。“我”作为给定的开头,没有评分;句号则由前一个位置预测,参与评分。如果加入起始标记,连第一个“我”也评估,计算项数就会改变。
1.71 可以理解成一种等效选择难度:假设模型每次在十个候选中平均分配概率,真实答案也在里面,那么 PPL 就是 10。
但 1.71 不表示模型真的只考虑了 1.71 个词,更不能换算成正确率。数学上,它是真实目标概率的几何平均值的倒数。
拿它比较模型时
换一套分词方式、换一段文本,或者改变模型能看到的前文长度,PPL 都可能变化。所以比较 FP16 和量化版本时,要使用同一个检查点,固定评估文本、分词和上下文设置。
评估整份数据,也要先累加所有有效目标的 NLL,再除以目标总数,最后取一次指数。直接平均每句话的 PPL,得到的通常不是整体 PPL。长文本采用滑动窗口时,重叠部分也不能重复计分。
量化可能改变模型给真实目标的概率,PPL 因而能帮助我们观察语言建模能力有没有受影响。
不过,它仍是一个平均值。有些位置变好、有些变差,最后可能得到相近的数字。生成的内容也未必一样。
这也是我关注有效计算时想分清的一件事:模型的分数接近,和人读起来的感受接近,还隔着一步验证。并且我认为这两者之间还有很大的gap。
参考:Hugging Face 的 PPL 教程。下一篇接着聊 SmoothQuant 的“近乎无损”。